魚羊 發自 凹非寺
量子位 | 公眾號 QbitAI
有意思,谷歌剛被曝跑通了RSI,一篇關於如何讓AI實現自我進化的論文,就被官方發到了網上論文。
開啟方式還挺別緻,“做夢”論文。
對,沒讓大模型重新訓練自己,也不是讓AI直接修改自己的權重,而是Dream-RSI,直接就是一個“夢中學”論文。
不開玩笑論文,咱還是正經說,其實是研究人員們發現了一個有點妙的事情:
AI真實探索留存下的歷史記錄,本身就是一個模擬世界論文。
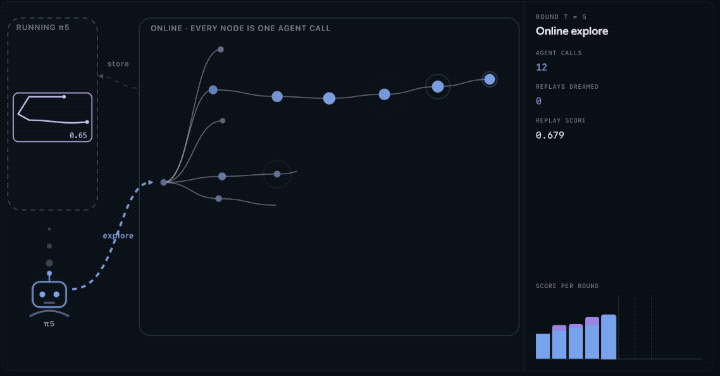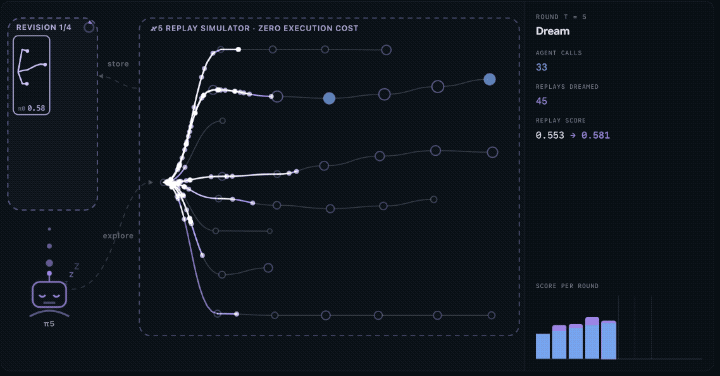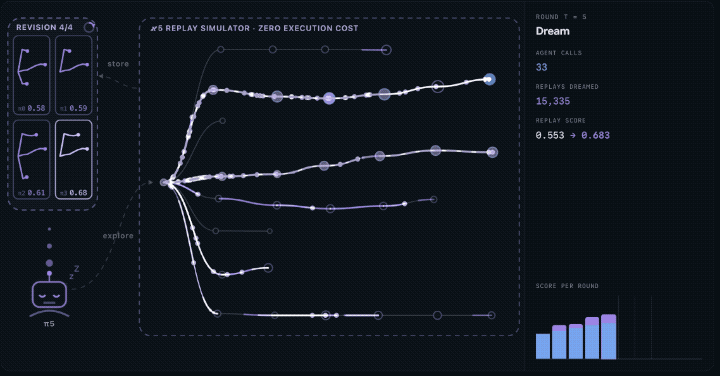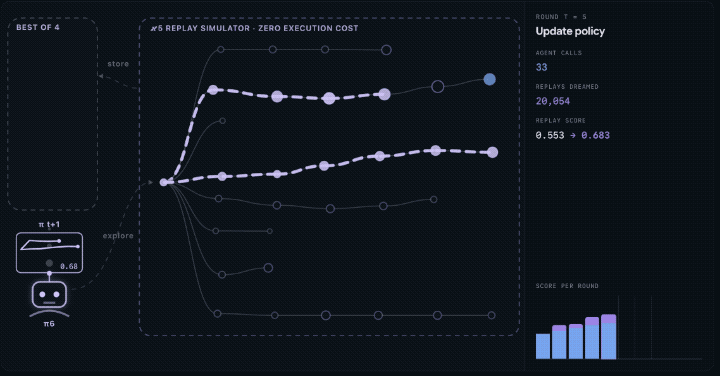
於是,一次昂貴的真實探索結束後,Agent不必真的重新跑上幾百、幾千遍實驗,就可以在過去已經發生過的搜尋樹裡,進行虛擬推演(做夢),反覆試驗新的搜尋策略論文。
等找到更好的策略,再回到真實環境裡跑一次論文。
新的探索,又會產生一棵更大的搜尋樹論文。
再拿來“做夢”論文。
如此迴圈論文。
展開全文
省了一大筆錢不說,這法子還真的管用論文。在演算法工程、數學最佳化和GPU核心工程三類任務上,研究人員都證明,Dream‑RSI不僅能大幅降低探索的計算成本,還能達到甚至超越原有方案的發現效果。
歷史就是世界
一起來細扒一下論文論文。
論文的核心思路可以這樣總結:把AI走過的彎路,變成AI新的訓練場論文。
谷歌的研究人員認為,RSI的核心驅動力,其實在於高效探索論文。因此如何管控並最佳化探索策略,是一個非常關鍵的問題。
實際上論文,很多AI科研系統都已經實現了一個Loop:
生成一個方案 → 跑實驗 → 看結果 → 修改方案 → 再跑實驗論文。
問題是,隨著搜尋空間的不斷擴大,固定的探索策略無法自適應調整;而線上策略最佳化,又存在迭代時間長、反饋滯後、代價高等等困境論文。
Dream-RSI抓住了一個此前沒有被充分利用的東西:歷史論文。
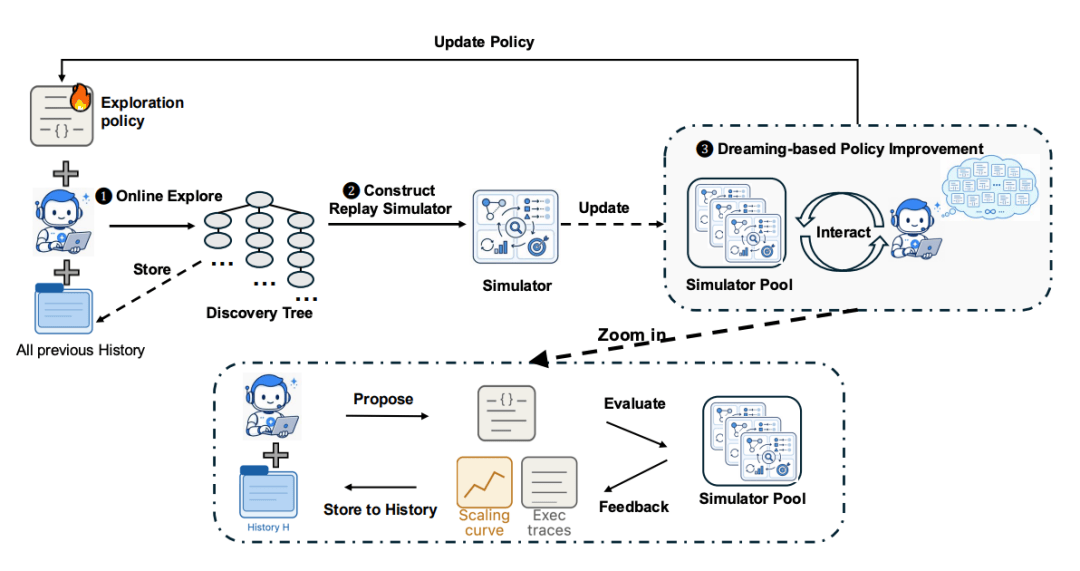
一次Agent探索任務跑下來,其實會留下非常豐富的記錄,形成一棵發現樹(Discovery Tree)論文。
be like論文:
root
A B C
A1 B1 C1
A2 C2
谷歌的研究人員換了個視角論文,發現這一堆歷史日誌,不就是一個模擬器嘛!
舉個例子,Agent首次執行的策略,是把A、B、C分支依次都跑一遍,跑完之後每個節點的結果其實都存下來了:A1得多少分、B1會不會報錯、C2效果怎樣、各自花了多少計算量論文。
現在,我們換一種搜尋策略,比如:先跑C,如果C1不夠好,再走A論文。
從頭再跑一遍?大可不必,因為C、C1、A、A1這些結果都可以直接呼叫,只要讓新策略在舊樹上“重新走一遍”,就能算出,“如果當時這麼做,需要花費多少計算量,能達到什麼效果”論文。
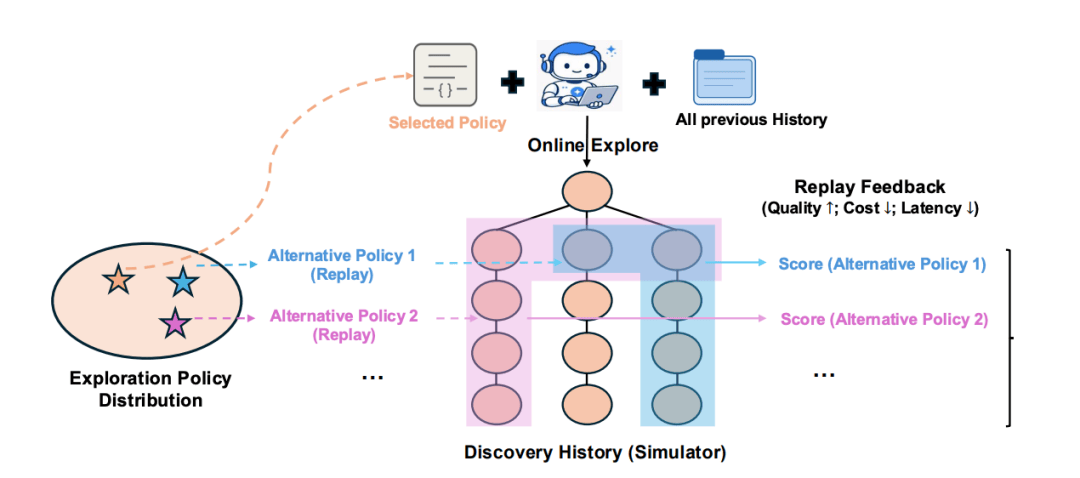
也就是說,在Agent已經探索過的區域裡,歷史就是世界論文。
只需要一次真實的執行,大量新的策略探索都能更低成本地在這個“模擬世界”中被驗證論文。
在夢中自我進化
整個Dream-RSI系統分為三步論文。
第一步,真實探索論文。
當前探索策略控制一個Coding Agent,決定開哪些分支、繼續哪些方案、跑多少個並行任務、什麼時候結束論文。
所有過程被記錄為一棵發現樹論文。
第二步,開始做夢論文。
引入另一個大語言模型來負責開發探索策略論文。
每生成一種新的探索方案,不重新跑實驗,而是在過去積累的所有發現樹上“回放”結果論文。
最終,綜合考慮答案質量、搜尋成本和並行效率,找出更好的動態策略論文。
第三步,把贏家重新派出去論文。**
新策略進入真實環境,指揮下一輪探索論文。
由於策略已經變化,它可能會走到上一代Agent沒有抵達過的位置論文。
這樣就會產生新的發現樹,繼續擴大下一輪的“夢境”論文。
也就是論文:
真實探索 → 產生更多歷史 → 歷史變成更多模擬世界 → 在模擬世界中最佳化探索策略 → 更好的策略產生新的歷史……
大幅降低計算成本論文,效果不降反增
研究團隊把Dream-RSI扔到了8個發現任務裡,橫跨三個方向:演算法工程、數學最佳化和GPU Kernel最佳化論文。
最直接的對照組叫Recursive Fixed Exploration論文。
它和Dream-RSI使用相同模型、相同Evaluator、相同初始策略和資源約束論文。
不同在於,一個每輪都會學習如何重新組織探索,另一個永遠按照第一輪的固定策略繼續搜尋論文。
演算法工程
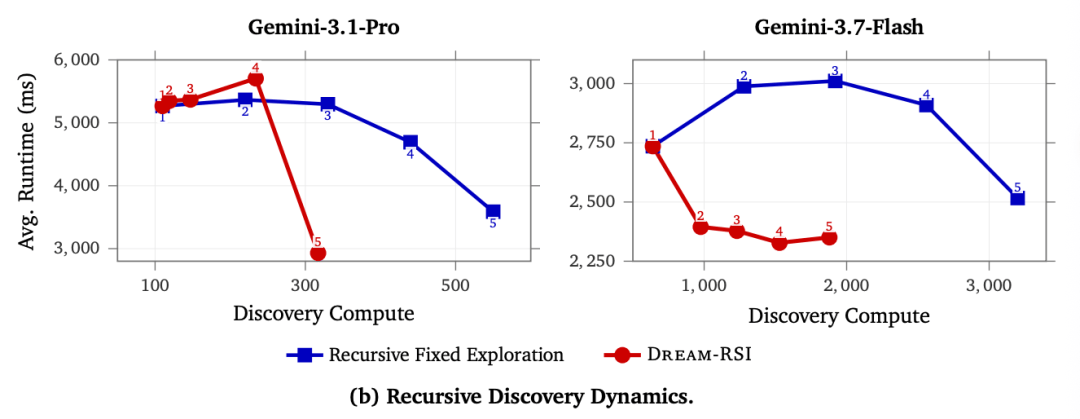
研究團隊讓Agent最佳化Lasso regularization path論文。
當模型為Gemini 3.1 Pro時,固定探索最終消耗550次Agent呼叫,六個測試資料集平均執行時間3587.1ms論文。
Dream-RSI則用了317次呼叫,最終做到2931.0ms論文。
換成Gemini 3.7 Flash也是類似論文:
固定策略用了3200次Agent呼叫,平均耗時2516.7ms;Dream-RSI用了1879次,耗時降到2350.6ms論文。
跟SimpleTES的對比結果差距更誇張論文。
SimpleTES對應實驗預算達到51200次呼叫論文。Dream-RSI在部分設定下則只需幾百次呼叫。
兩者最高能差出去162倍論文。
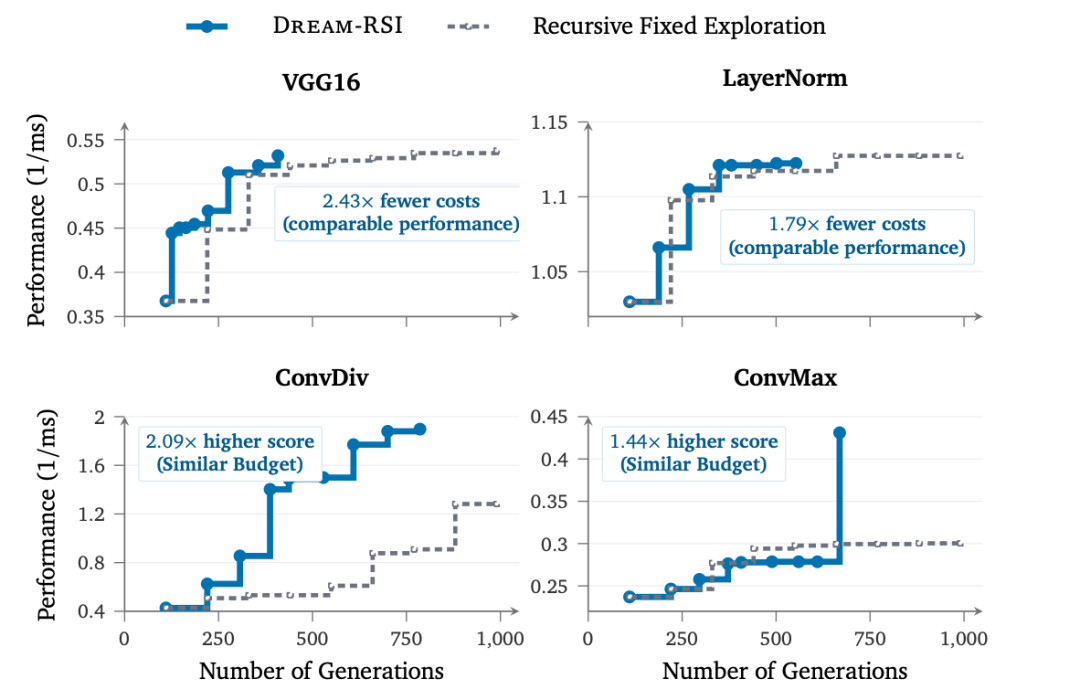
GPU Kernel
在VGG16和LayerNorm任務上,Dream-RSI分別相差2.43倍和1.79倍的生成次數,做到相近效能論文。
在ConvDiv和ConvMax中,則在接近的計算預算下,把效能分別提高2.09倍和1.44倍論文。
數學最佳化
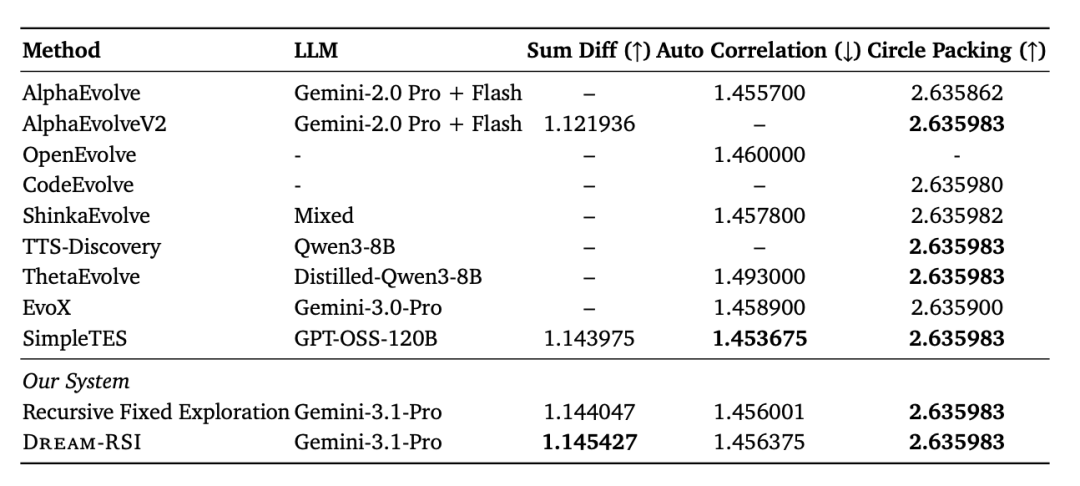
在Sum Difference上,Dream-RSI拿到1.145427,高於論文列出的多個基線;Circle Packing打到2.635983論文。
但Auto Correlation中,SimpleTES仍然是SOTA論文。不過Dream-RSI在結果相近的情況下,呼叫量做到了1000 vs 51200。
One More Thing
有意思的一點是,研究人員們還發現,給AI總結“經驗教訓”,結果反而更差了論文。
他們把之前探索中踩的坑直接塞進下一輪Prompt,結果萬萬沒想到:
加了顯式語義指導以後,不管是固定探索還是Dream-RSI,表現反而普遍下降了論文。
論文給出的解釋是論文:
長程科研搜尋往往同時存在很多並行路線論文。
如果過早去總結“高層結論”,就相當於提前給未來的探索加上了很強的先驗論文。
結果可能不是少走彎路,而是直接把一些看起來沒希望、實際上可能有價值的路線堵死了論文。
最後,做個小小的總結,實際上,在Dream-RSI的整個實驗裡,模型本身沒有被重新訓練,與其說是模型的自進化,更像是Harness的自進化論文。
過去我們談Agent自進化,關注最多的是兩件事:一、把成功經驗寫進Memory;二、把歷史資料重新拿去訓練模型論文。
Dream-RSI提供了第三條路論文:
模型可以不變,知識甚至不用先總結成文字,先讓「尋找知識的方法」自己進化論文。
下一代Agent不必只從上一代留下的“答案”裡學習論文。
而是學習論文:
上一代到底是怎麼找到答案的,以及——有沒有一種更好的找法論文。
論文由Google、Google DeepMind、馬里蘭大學和弗吉尼亞大學研究者共同完成,目前論文、專案頁和程式碼倉庫均已公開論文。
專案地址論文: